Datenexport vor Systemwechsel

Ich habe Daten von 2017 bis 2026 in meinem Plenty System, und möchte vor Vertragsende noch möglichst viel exportieren, um die Daten zu archivieren (falls sie später nützlich sind, es ist kein Import in ein anderes System geplant).

Hat das jemand gemacht und konkrete Praxis-Tipps, insbesondere zu Auftragsdaten (und somit etwaigen Verkaufsdaten/Statistiken)?

Ich nehme an, dass der Katalog das alles exportieren kann, aber ich bin nicht ganz am Laufenden was man da einstellen muss bzw. ob der Katalog überhaupt noch der “Export für alles” ist?

Wäre vielleicht doch der elastische Export geeigneter, um Auftragsdaten zu exportieren?

Wir exportieren für unser BI System regelmäßig alle historischen Daten aus Systemen und nutzen dabei Kataloge. Es ist aber nicht so simpel wie “Exportier mir alles von 2016 bis heute”.

Ein großes Problem kann die maximal mögliche Anzahl Aufträge/Auftragspositionen pro Export und damit insgesamt die Anzahl an einzelnen Exporten sein. Je nach Datenmenge (Anzahl Aufträge und Auftragspositionen pro Monat) ist es bei uns oft der Fall, dass wir die Exporte so klein aufteilen müssen, dass nur wenige Tage in einen einzelnen Export gefasst werden. Das ergibt bei zig Jahren dann schnell hunderte Exporte. Wir haben das halbwegs automatisiert, aber selbst damit ist es ein ziemlich aufwendiger Prozess.

Welchen Mengen liegen bei dir ungefähr vor?

Zum reinen Archivieren ist für dich vielleicht auch der Rohdaten-Export interessant, wobei die je nach Typ nicht unendlich in die Vergangenheit reichen.

Etwa 80k Aufträge in der gesamten Zeit. Wobei man Amazon Aufträge eventuell ausschließen könnte.

Was sind so die Limits je Export?

Die Stats Rohdaten reichen doch nur 24 Monate oder? Das hilft mir wenig, die Zeit davor wäre eher interessanter.

Kataloge können 60.000 Zeilen pro Export, und Datumsfilter maximal 3 Monate. Bei dir wird also eher der Zeitraum der beschränkende Faktor. Du müsstest also alle Daten in 3-Monats-Schritten exportieren, wenn du Kataloge nutzt.

Der dynamische Export kann bis 1 Jahr als Zeitraum, aber dafür nur 6.000 Zeilen. Ist also ähnlich praktikabel für dich, je nachdem wie sich die Mengen verteilen und wie viele Auftragspositionen es gibt.

Um sicher zu gehen, dass alle Daten enthalten sind, sollte natürlich immer deutlich unter den rechnerischen Limits gearbeitet werden, damit Spitzen nicht plötzlich zu abgeschnittenen Daten führen.

Rohdaten sind dann wahrscheinlich tatsächlich nicht der Weg.

So, ich habe jetzt mal die Backup Datei (bei mir ca. 900MB unkomprimiert, ca. 5 Mio. Zeilen im Texteditor) heruntergeladen, und spaßeshalber Claude gefragt, ob man da sinnvoll Daten rausbekommen könnte (obwohl die SQL Daten in der Backup Datei bewusst unvollständig sind, Spaltennamen fehlen z.B.).

Claude hat sich die Tabellennamen und Beispielzeilen angesehen, und ist recht zuversichtlich, dass es damit alles was fehlt rekonstruieren kann (um die exportierten Daten lokal z.B. in einer SQLite Datenbank zugänglich zu machen).

Ich bin mal gespannt, was rauskommt. Wenn es klappt wäre das VIEL einfacher als zig Exporte über den Katalog etc. zu machen.

Zwischenstand: Claude hat ein Phython Script (ca. 600 Zeilen Code bisher) programmiert, das das Backup (.sql Datei) einliest und die Daten von einigen Tabellen in eine neue SQLite Datenbank schreibt.

Es ist noch etwas Finetuning nötig, um die wichtigsten Datenfelder korrekt rekonstruieren zu können (um Aufträge, Kundendaten, Produktdaten etc. zugänglich zu machen).

Cool! Ich hatte - lange bevor LLMs ein Thema wurden - da selbst mal drin rum gewühlt, und recht schnell entnervt aufgegeben :see_no_evil_monkey:

Die Lösung die „einfacher als Exporte“ ist, die ich dann gewählt hatte, war die API. Geht auch gut, und ziemlich vollständig. Aber direkt die DB auslesen ist natürlich die bessere Option :ok_hand:

Meine Motivation die API und DB anzusehen: Ich habe auf “neuer Katalog” geklickt, und schon beim ersten Popup (wo etwa hundert Marktplätze zur Auswahl stehen, obwohl man nix mit Marktplätzen machen will) frustriert aufgegeben.

Ich dachte “bevor ich mich mit der Kataloge-UI herumschlage, die ich seit 1 Jahr nicht genutzt habe: Vielleicht kann Claude ja selbst die API Doku recherchieren und ein Script für API Zugriff programmieren, wäre wohl einfacher”.

Das mit dem DB Export war dann eher Zufall. Die Herausforderung ist natürlich die Spaltennamen zu rekonstruieren, was bei Auftragsdaten aber machbar ist (was ist der Name, was ist der Brutto Preis etc.). Verknüpfungen zwischen Aufträgen/Positionen/Kunden sind auch kein Hexenwerk. Was man schwierig rekonstruieren kann sind Tabellen die Daten nur verknüpfen, aber das braucht man nicht wirklich, wenn man vor allem Aufträge später nach ansehen können möchte.

Wenn etwas draus wird kann ich das Script teilen (wobei ich noch nicht weiß, ob es rechtlich ein Problem ist, ein “Plenty Backup auslesen” Script zu veröffentlichen).

Welches rechtliche Problem soll sich da ergeben? Schlimm genug, dass man kein echtes, vollständiges Backup aus dem System bekommt. Hilfe zur Selbsthilfe ist da einfach nur Notwehr.

So, ich habe mit Claude noch weiter an der Bereinigung der Daten gearbeitet. Auftragsherkünfte waren wirklich ein Problem, da es sehr viele gibt, und sich die Logik auch geändert hat. Wir haben das dann über die Email Adressen gemacht, um Amazon/eBay/Webshop+Manuell/Interne Aufträge zu unterscheiden.

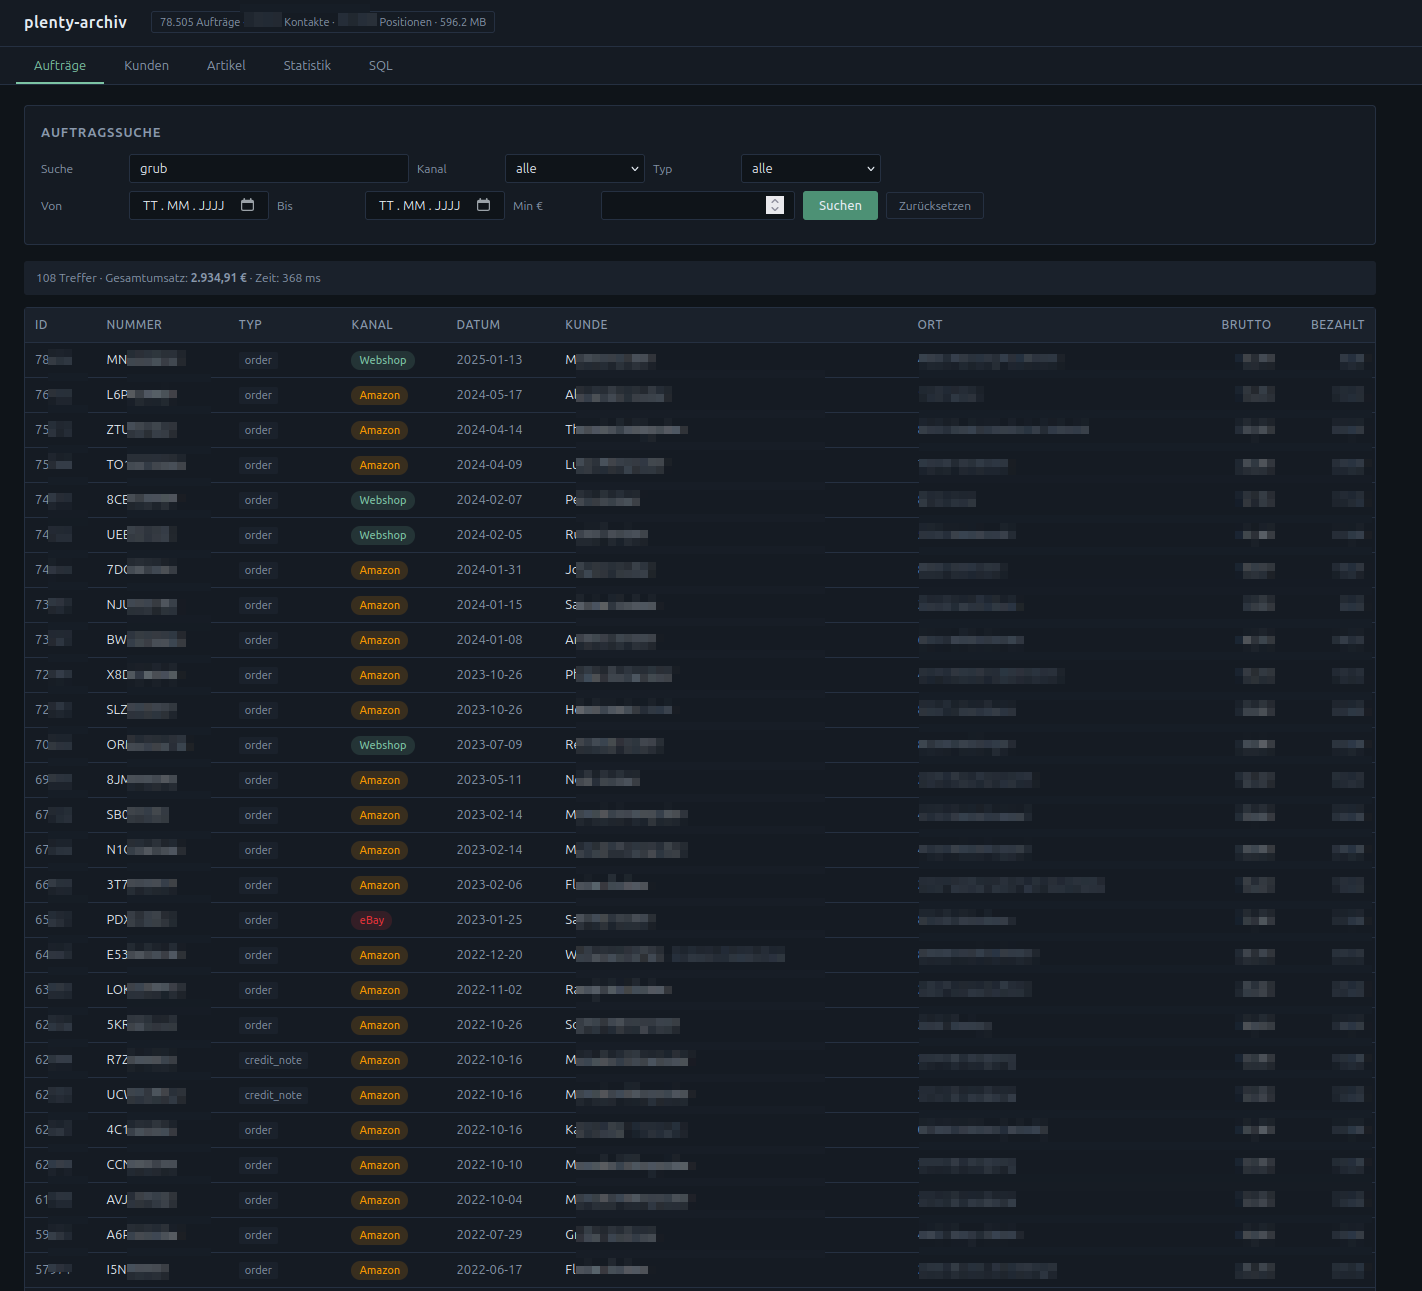
Claude hat mir dann gleich eine lokale Webserver Interface Lösung programmiert, sprich ein python Script startet einen kleinen lokalen Webserver, und man ruft das dann via localhost im Browser auf.

So sieht das Interface aus, erster Versuch, ohne jegliche Vorgaben zur UI. Imho hat Claude schon beim ersten Versuch eine bessere UI als bei P. geschaffen. Das ist die Auftragsansicht:

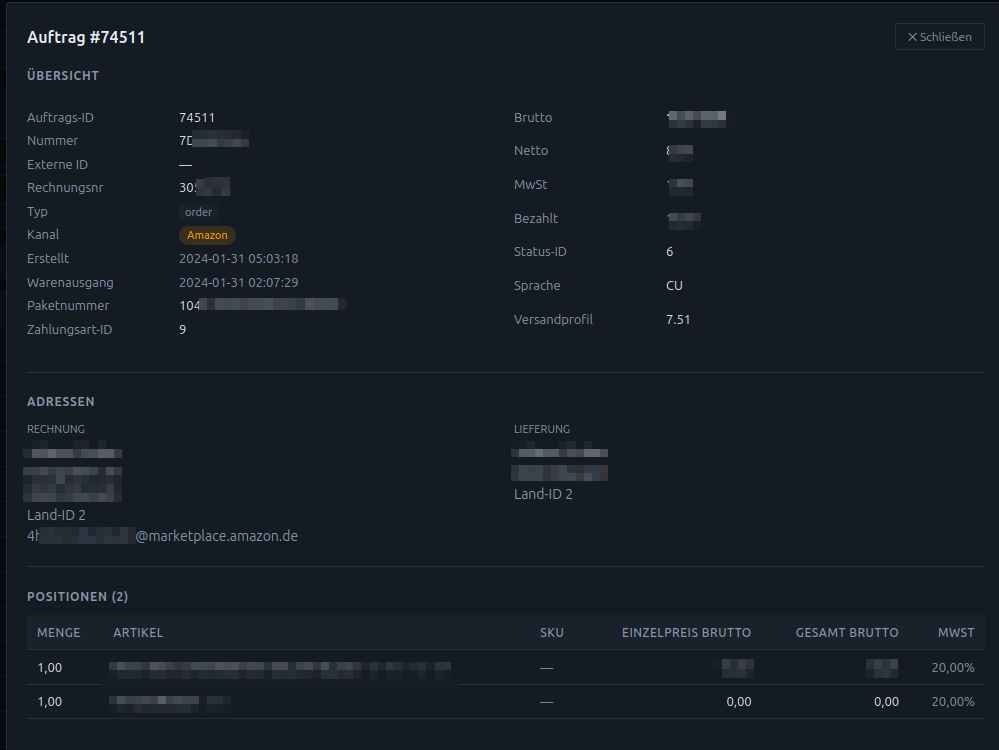
Das ist die Ansicht wenn man einen Auftrag öffnet:

Das ist alles noch etwas roh, so werden Länder zB noch nicht angezeigt, es wird nur die “Land ID” ausgegeben. Solche Infos müssen ergänzt werden, das ist eben das nötige reverse engineering, da die Daten im Backup unvollständig sind.

Wenn Interesse besteht, kann ich den aktuellen Stand (Scripts) veröffentlichen. Diese Scripts sind allerdings noch keine fertig nutzbare Software (die mit anderen Plenty Datenbanken ebenso funktioniert), sondern eine Ausgangsbasis, um mit einem LLM eine passende Lösung für die eigenen Daten zu bauen.

Die Arbeitsweise mit einem LLM wie Claude (Opus 4.6 in meinem Fall): Man beschreibt das was man möchte (etwa Daten aus dem Plenty Backup zugänglich machen). Das LLM gibt dann Bash Befehle, die aus dem Backup z.B. die Namen aller Datenbank Tabellen oder Beispiel-Zeilen herauslesen. Diese Ergebnisse übergibt man dem LLM. Das LLM passt dann das Script immer weiter an.

Mit dem Script kann man dann die Backup Datei in eine lokale SQLite Datenbank konvertieren (oder in eine andere Datenbank speichern). Diese Datenbank kann man dann mit SQL Queries abfragen, und so das Ergebnis weiter verbessern.

Am Ende hat mir Claude dann das Auswertungstool gebaut, das auf diese lokale Datenbank zugreift. Ziel ist, dass man die Plenty Daten in dieser Form archivieren kann, und bei Bedarf recht einfach z.B. einen Auftrag öffnen kann.

Sieht fast aus wie Odoo im Dark Mode. :sweat_smile: