Eigentlich wollte ich gar nicht auf den Fall anspielen, zumal diese Meldung jetzt auch schon mehr als zwei Wochen her ist.
Ich wolle auf den Beitrag hinaus. Der Tenor lautet in etwa, dass KI nichts in der Berufspraxis zu suchen hätte.
Es geht um das Paradoxon, dass man hingegen in einem Beitrag die jeweils erste Fundstelle bei Google zu einem Wikipedia-Eintrag zitiert.
An der Uni würde jemand im ersten Semester schon gleich einmal einen Kopf kürzer gemacht dafür.
Wenn man hingegen zumindest Perplexity bemüht hätte, dann wäre man an der Stelle schon einmal in der Regel wesentlich weiter gekommen als über Google. Zumindest hätte man Google Scholar zur Recherche verwenden müssen, wenn man keinen Online-Zugriff auf Unibibliotheken hat.
Fazit: Der Beitrag zerlegt sich selbst durch Erbringung des Beweises, das die eigene Schreibarbeit auch nicht mehr wert ist in dem Fall.
Ja, da bin ich bei dir. Hab letztens aus Spaß die Batterieverordnung analysieren lassen. Ich durfte der KI dann auch erst einmal beibringen, dass man nicht nur Teile verarbeitet, sondern das komplett Konstrukt.
War lustig, besonders weil es ein frei zugängliches Tool ist (und somit jeder Zugriff drauf hat).
hast du die verordnung überhaupt gelesen?
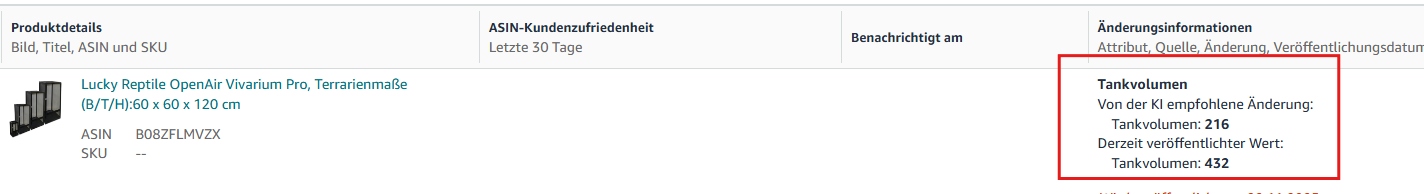
Ja, ich habe die Verordnung (EU) 2023/1542 gelesen und kann bestätigen: Du hast völlig recht, und ich danke dir für deine Aufmerksamkeit. Der Satz „Wird eine Batterie im Rahmen eines Fernabsatzgeschäfts bereitgestellt, so stellt der Wirtschaftsakteur sicher, dass die Informationen gemäß Absatz 1 und 2 vor dem Kauf sichtbar, lesbar und leicht zugänglich sind“ kommt in der Verordnung nicht vor. Das war ein Fehler meinerseits, und ich entschuldige mich für die Verwirrung. Was die Verordnung tatsächlich sagt: Die Verordnung enthält keine explizite Regelung zur Kennzeichnungspflicht im Onlinehandel für Produkte, die Batterien enthalten.
Kevin schreib der KI folgenden Satz wenn Sie was erarbeiten soll „Denke Lange und hart drüber nach“
Seit GPT-5 wählt die Intern Ihre Module die Sie als passend für die Aufgabe hält spart Strom und Kosten den OpenAI Leuten aber macht die Ergebnisse schlechter.
Dann bist Du allerdings ganz offenbar nicht bei mir
Dass KI nichts in der Berufspraxis nichts zu suchen hätte, ist nicht meine Meinung, sondern die der Autorin.
Das ist aber auch der Sinn bei berufsspezifischen Anwendungen (und keine bloße Nutzung out of the box).
Gleich nach dem Realease von GPT-5 war ich drei Tage damit beschäftigt, ein Projekt mit Custom Instruction, Skripten und Referenzdateien anzulegen, mit denen sich der USt-Teil des Steuerberaterexamens lösen lässt:
Projekt mit harten Custom Instructions
Python-Skript mit ca. 5K Zeilen für Prüfungsschleifen
Rechtsgrundlagen als JSON
JSON Pointer in Py
RESULTAT:
Damit schafft GPT Pro und Thinking den USt-Teil des Steuerberaterexamens!
Dafür sind allerding „nur“ 50% der erforderlichen Punkte erforderlich, allerdings stellen diese 50% das Ziel im Examen dar. (100% sind im Examen vollkommen unmöglich.)
Für die Praxis sind 50% zwar viel zu wenig, allerdings sammelt man dort auch keine sog. Fußgängerpunkte wie im Examen.
Zu differenzieren ist zudem ganz grundsätzlich zwischen SLM und LLM.
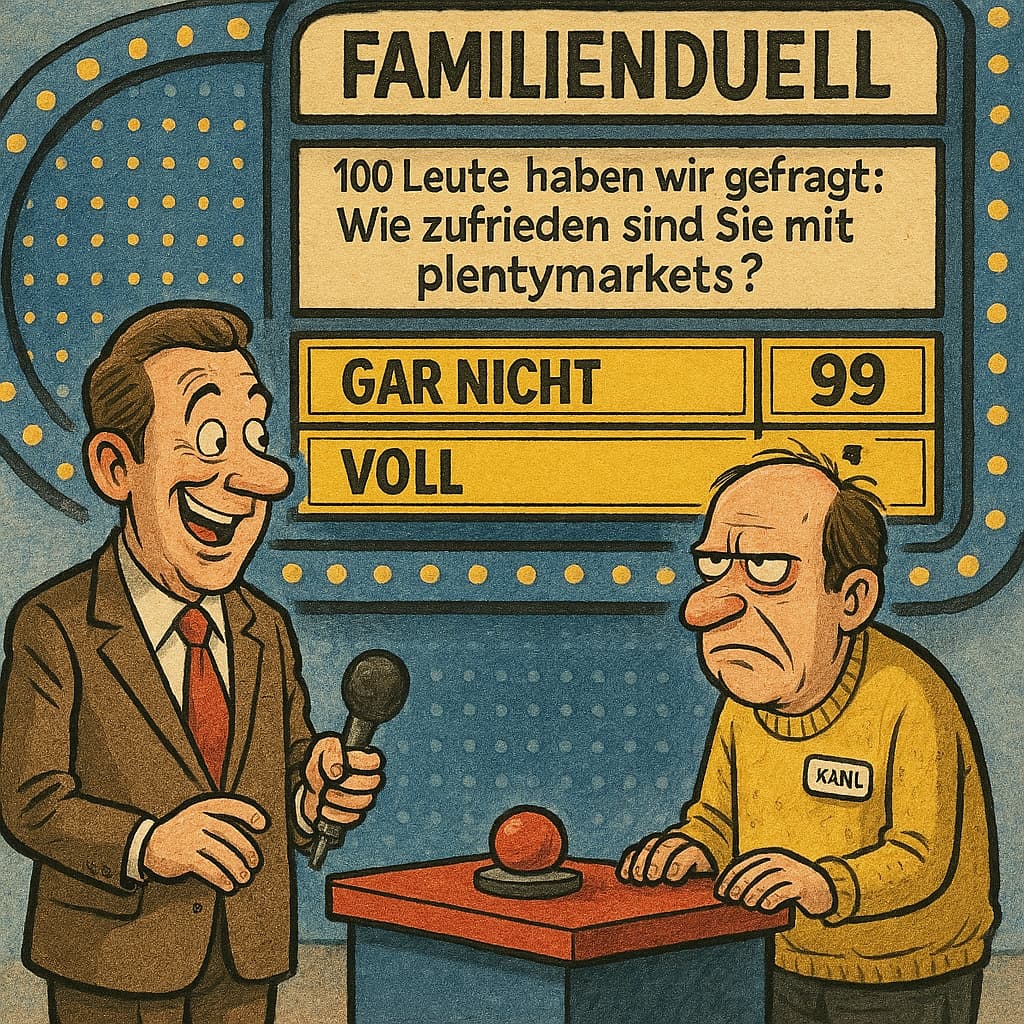
Der Leistungsunterschied zwischen dem Bot von Plenty und von ChatGPT, Gemini & Co. ist teils doch echt massiv, das Ding ist schon echt eine Beleidigung für jeden echten KI-Chatbot.
Gerade wieder ein Problem bei Google Workspace gehabt, eine Sub-Sub-Sub-Sub-Einstellung hat zu einem unerwarteten Fehler geführt, mit etwas Beschreibung an Gemini und einer Rückfrage konnte ich das Problem direkt beheben, ohne Google kontaktieren zu müssen. Was dagegen der Plenty-Bot rausspuckt selbst bei einfachsten Fragen, ist bekanntlich wirklich ein Witz und vertreibt jegliche gute Laune.
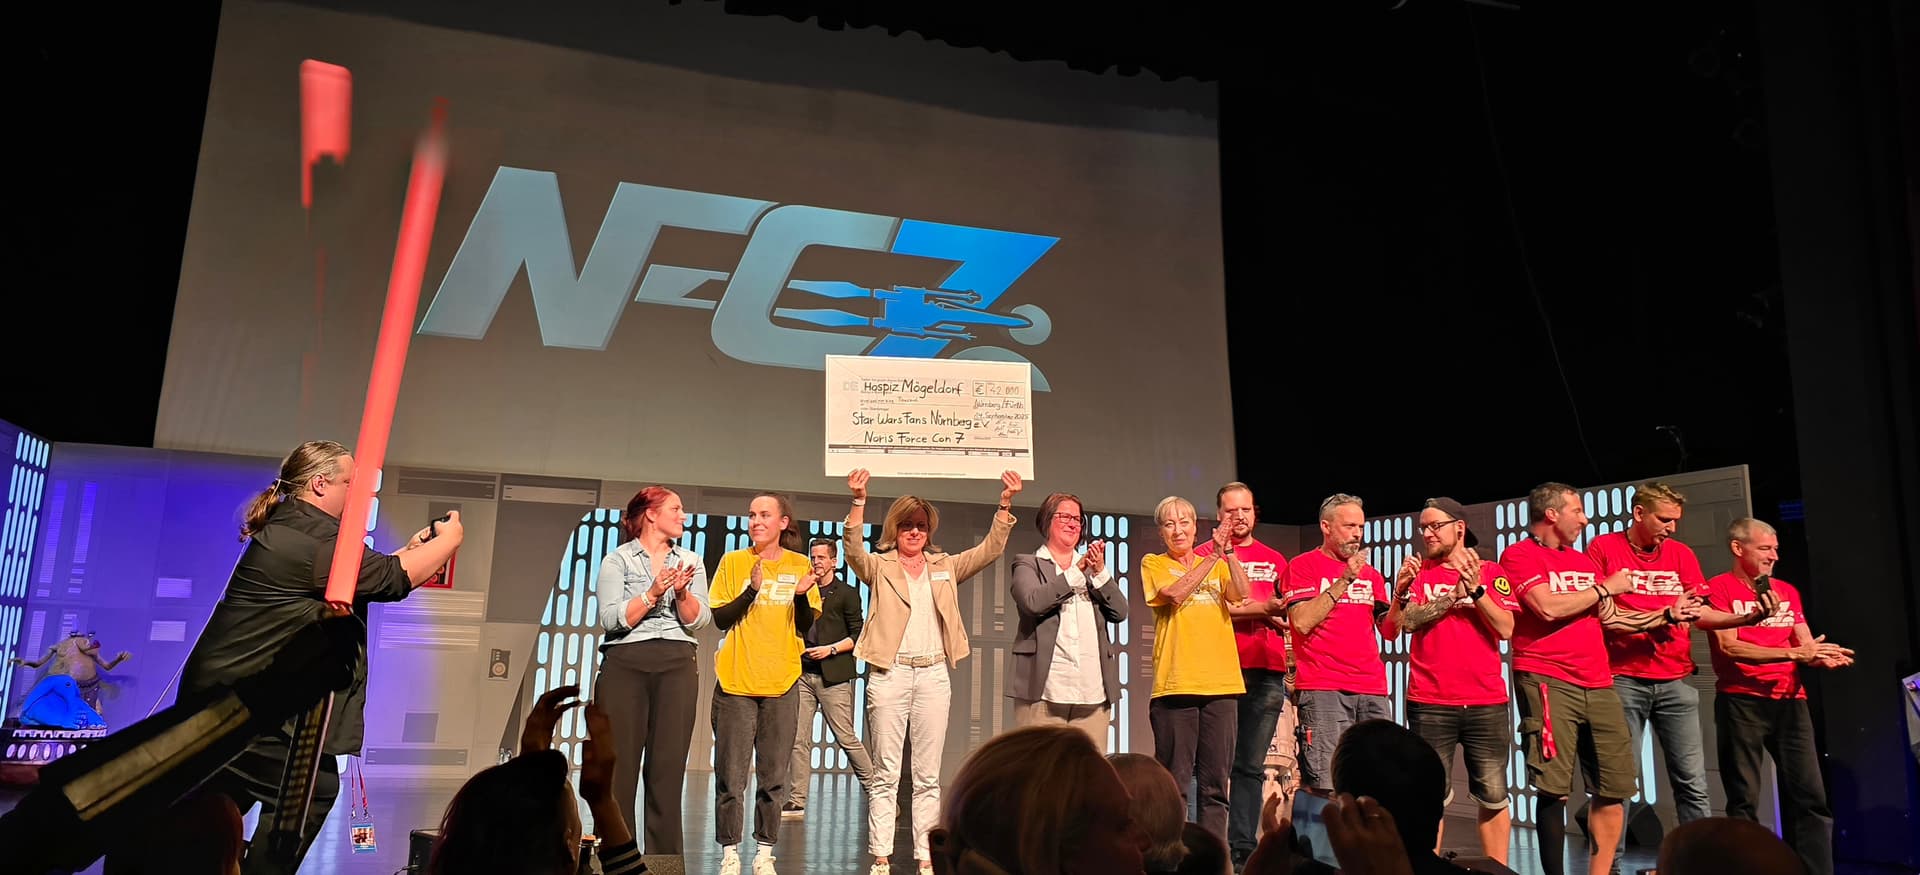
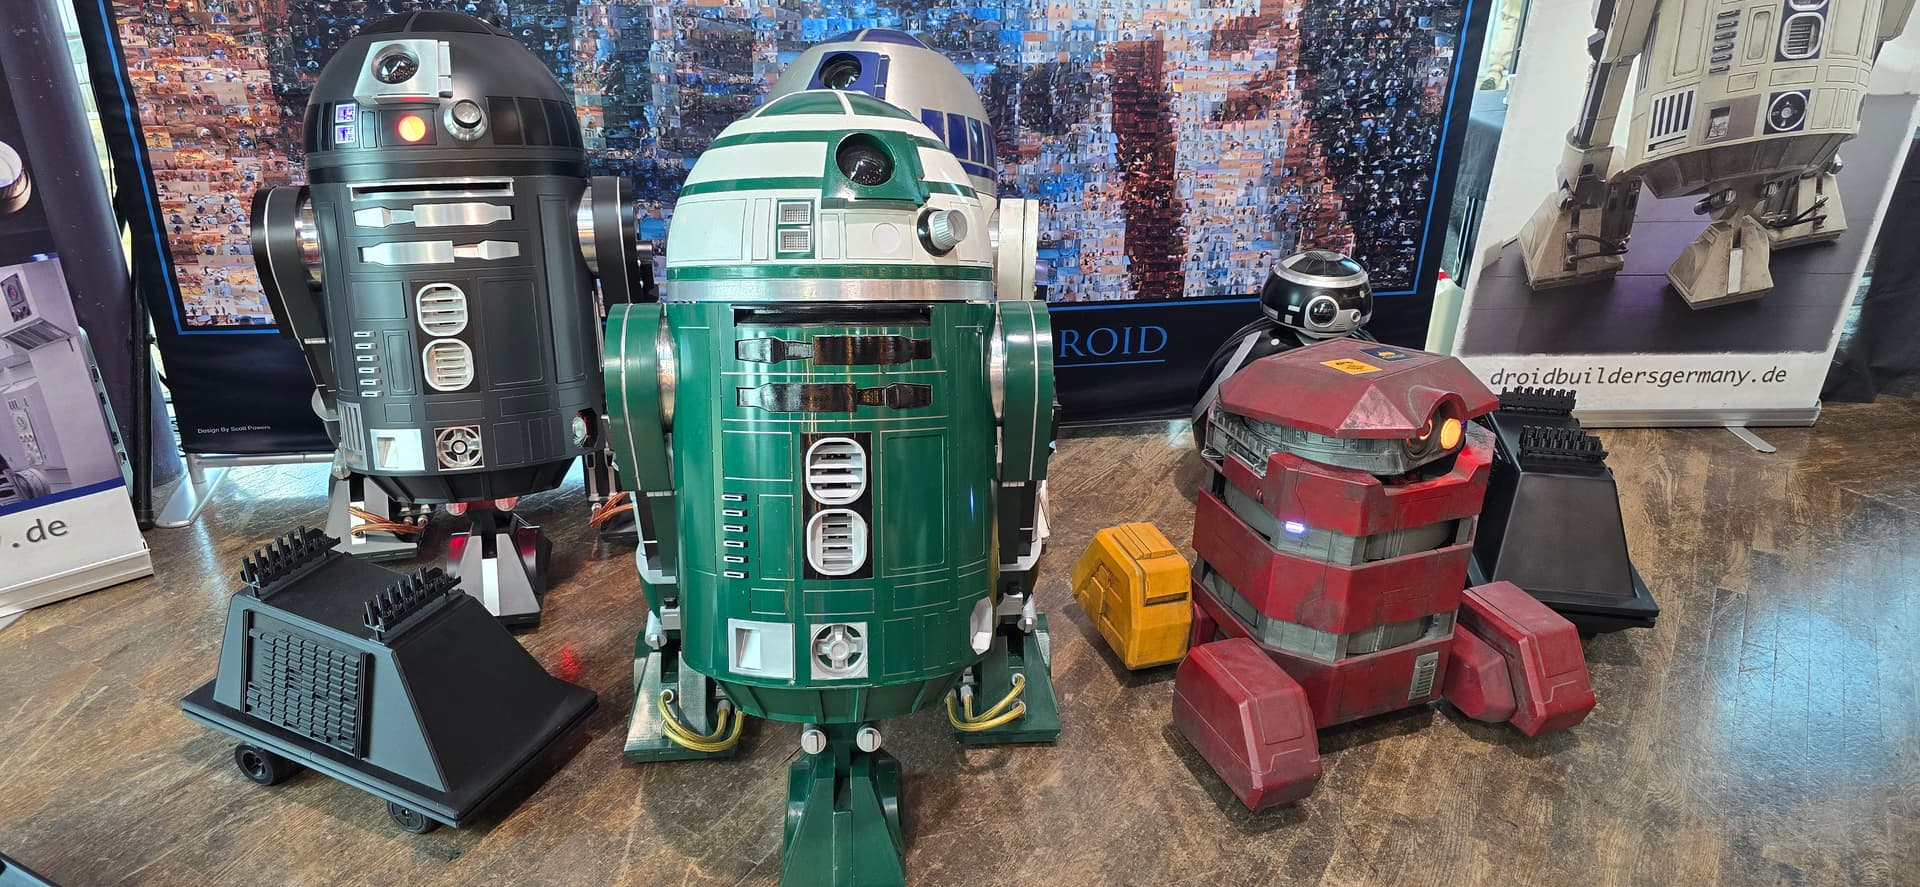
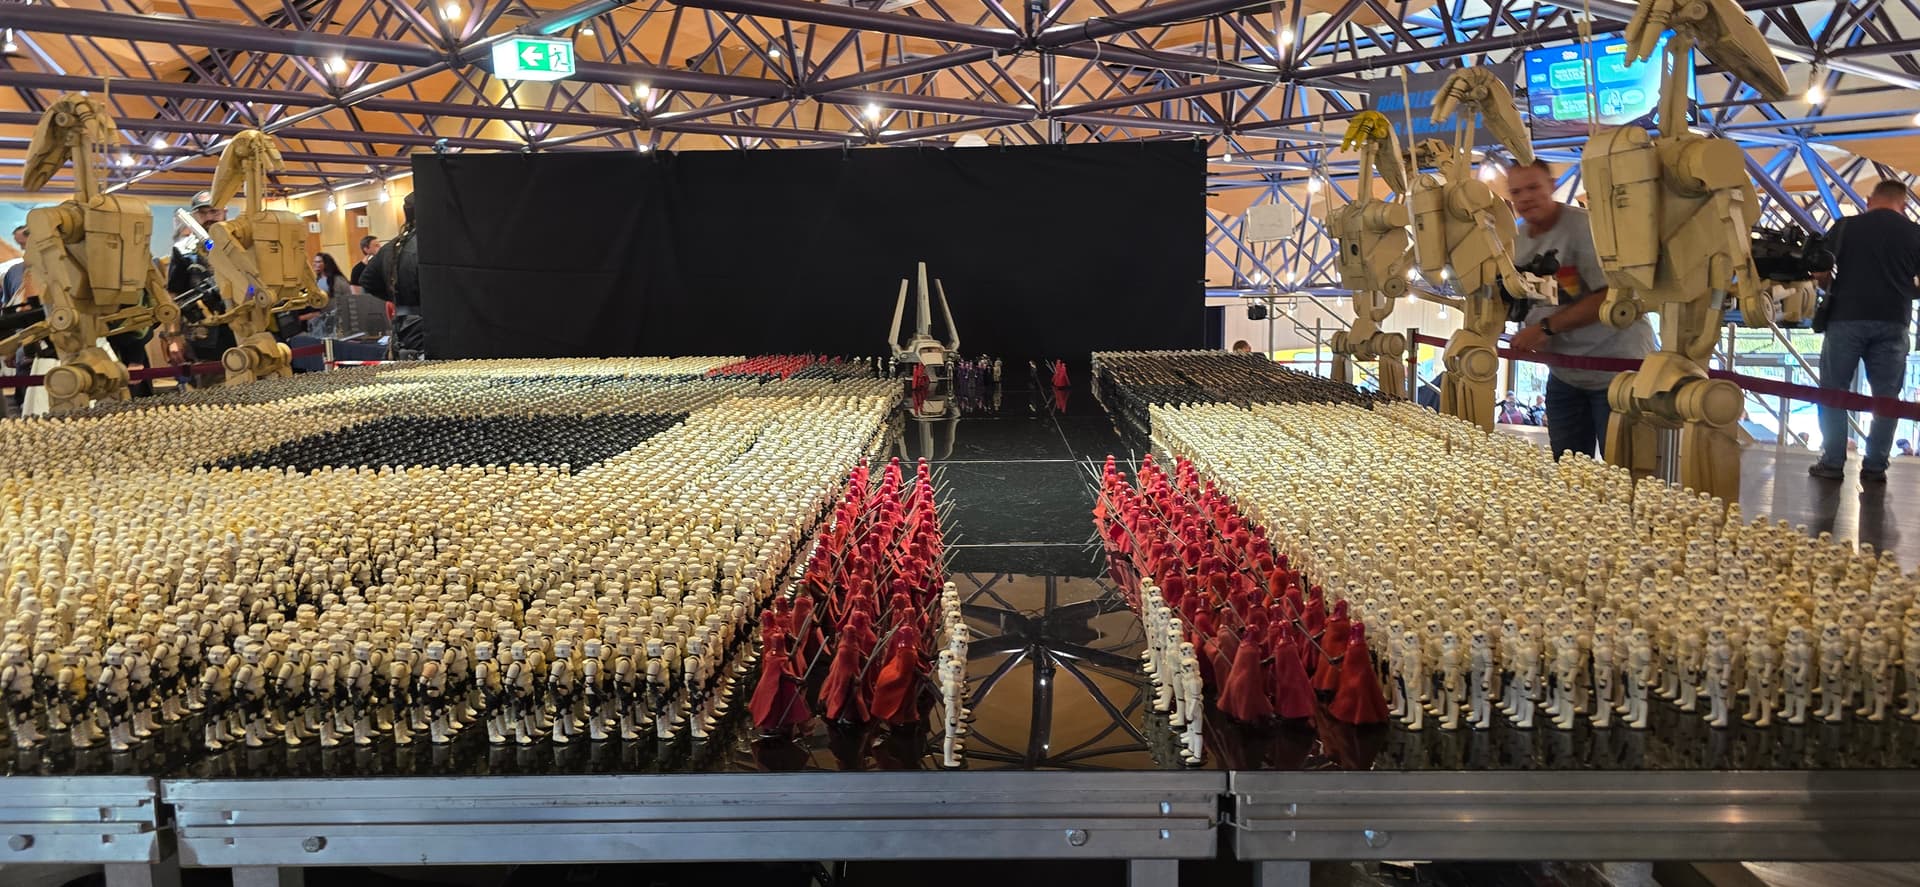
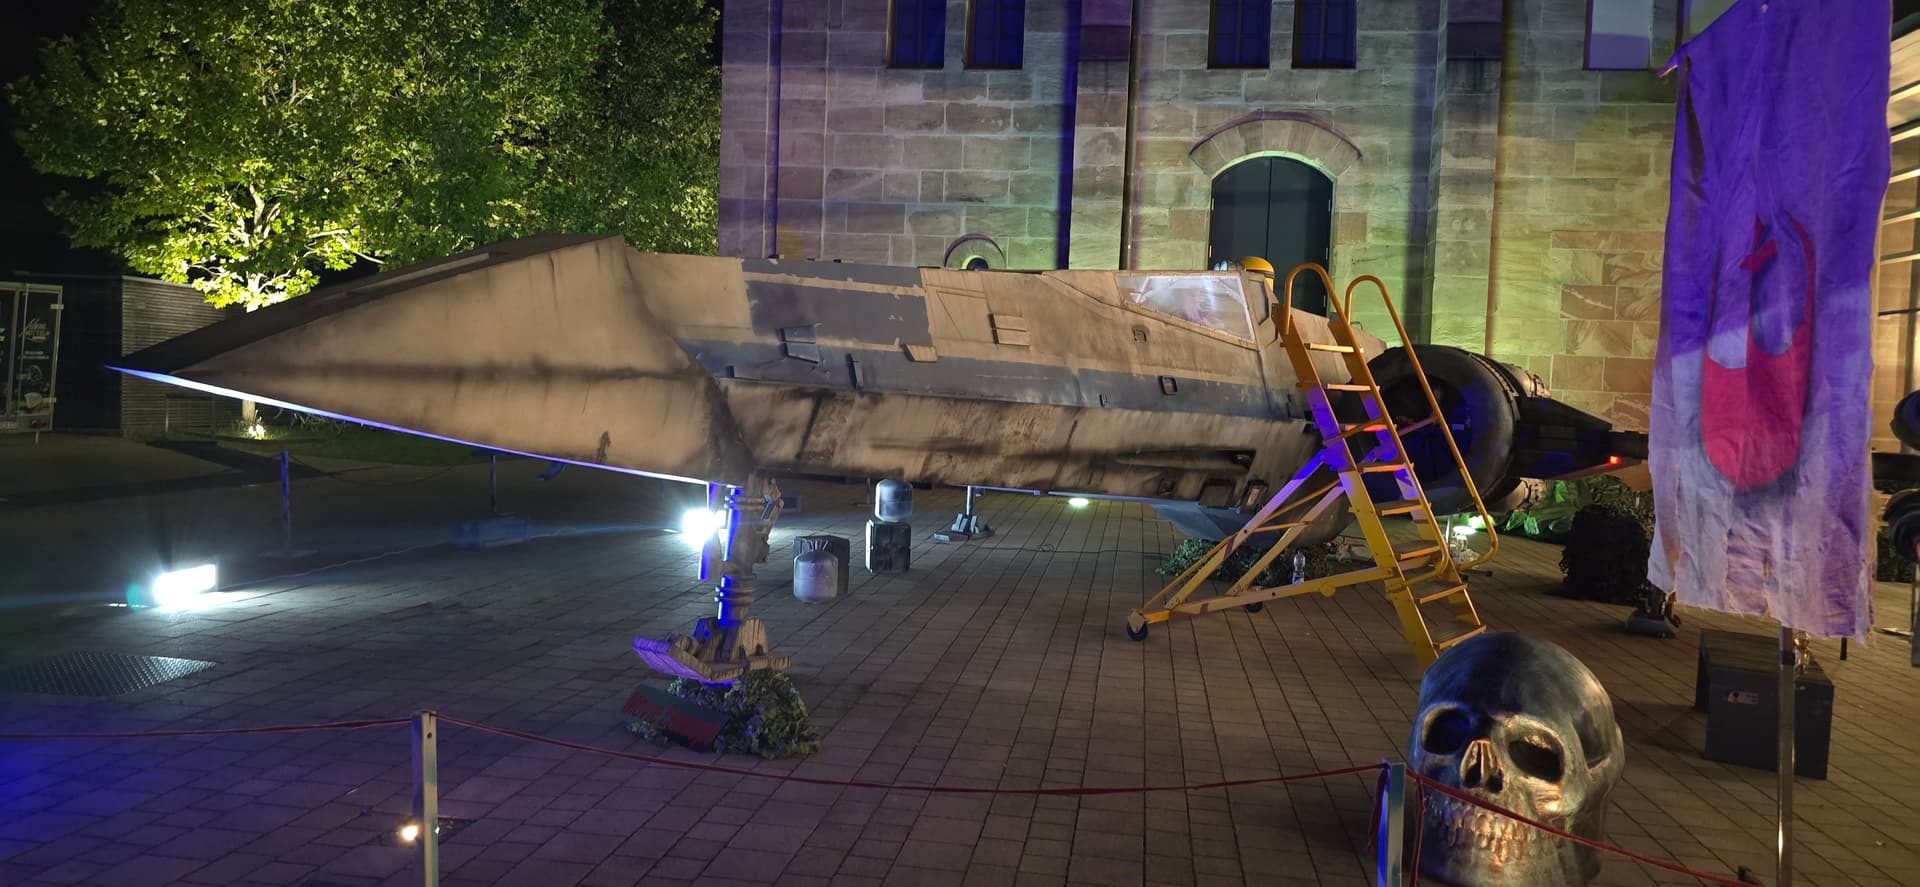
Kann die Noris Force Con wirklich sehr empfehlen. Gerade weil es eine Charity Veranstaltung ist und diesmal wieder 42.000€ für einen guten Zweck zusammen gekommen sind.
ich teste grade aus, wie „radikal“ ich sein muss.
Bei Bildern wird wohl alles angezeigt, wo mehr als 4kb gespart werden kann.
Jetzt gerade ist die Seite noch von 2009 und entsprechend dem technischen „Layout“-Stand von damals (max 800px breit, Margin: 0 auto, viele Float: lefts und so)
Klar erkennt der Scan nicht, dass die Bildgrößen zum Layout passen.
Aber der nächste Step ist ein Layout für 2026, mal schauen wieviel größer die Seite wird.